Caída de Google Cloud y resiliencia en banca
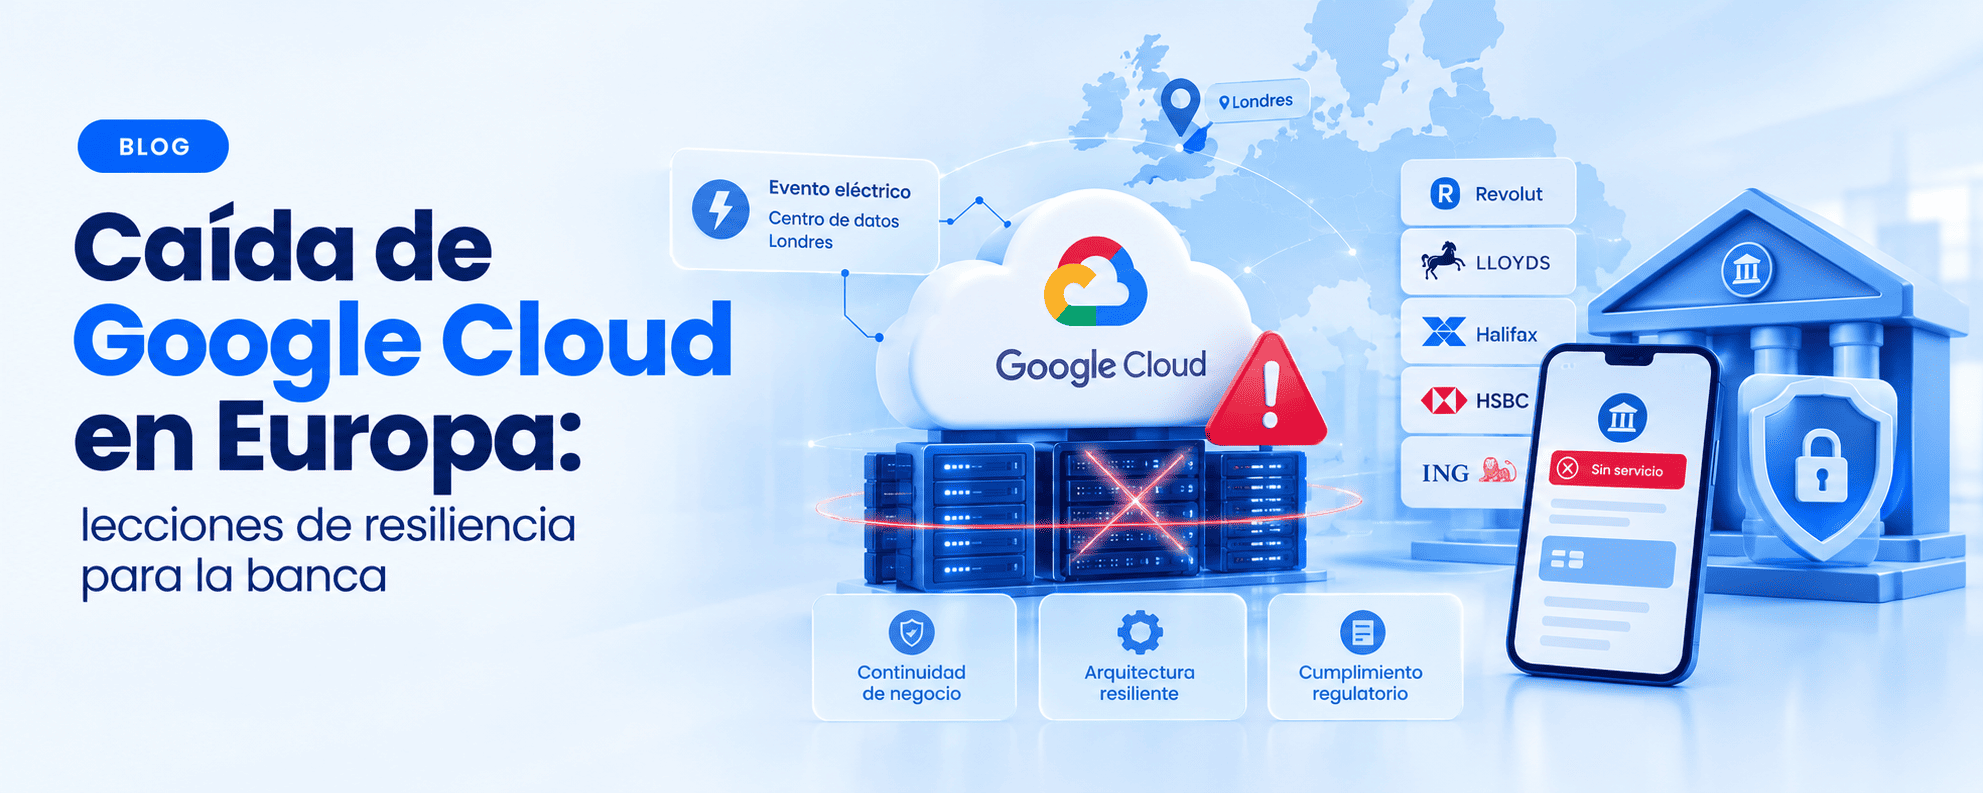
La caída de Google Cloud del 20 de octubre de 2026 dejó durante horas sin servicio a clientes de Revolut, Lloyds, Halifax, HSBC e ING. En España, muchos usuarios de Revolut no pudieron pagar con tarjeta ni sacar dinero del cajero durante toda la mañana. El origen no fue un ciberataque. Según explicó Google, se trató de un evento eléctrico en uno de sus centros de datos de Londres.
Para un líder de TI, la pregunta no es si su proveedor cloud fallará algún día. La pregunta es qué pasará con sus servicios críticos cuando eso ocurra. Además, el incidente llega en un momento sensible: los reguladores europeos y británicos ya supervisan de forma directa a los grandes proveedores de nube.
En este artículo verás qué pasó, por qué una falla localizada llegó hasta la app de un banco, qué dicen las normas y qué puedes revisar en tu arquitectura durante los próximos 30 días.
Qué pasó en la caída de Google Cloud del 20 de octubre
El incidente empezó a las 8:08 de la mañana, hora de España (6:08 GMT). Google lo atribuyó a un “evento eléctrico” en la zona europe-west2-b, ubicada en Londres. Aunque la empresa indicó que el problema se limitó a ese centro de datos, servicios en otras partes de Europa registraron errores y fallas de red intermitentes, de acuerdo con la cobertura de ABC News sobre la falla en Europa.
Los bancos afectados por la caída
- Revolut: el caso más visible. Su portavoz atribuyó la incidencia a la caída de Google Cloud y aseguró que los fondos y los datos de sus clientes estaban a salvo. Revolut Business también tuvo fallas en la app, la web y el cobro a comercios.
- Halifax: sus clientes en el Reino Unido no pudieron entrar a la banca móvil, según ABC News.
- Lloyds: reportó problemas de acceso. Halifax y Lloyds pertenecen al mismo grupo, Lloyds Banking Group.
- HSBC: también registró incidencias de acceso, aunque no las vinculó de forma explícita con Google Cloud.
- ING: en Alemania, informó problemas técnicos en su banca online y su app el mismo día, según El Español.
La interrupción se extendió hasta la tarde. Finalmente, Google informó que el problema estaba mitigado para la mayoría de clientes y anunció que publicará un análisis cuando cierre su investigación interna.
No es un caso aislado
En julio de 2026, una falla en la red eléctrica que alimentaba la zona europe-west4-a, en los Países Bajos, afectó la energía y la refrigeración del centro de datos. Según un reporte del medio especializado W.Media, la zona estuvo fuera de servicio casi 15 horas. Por lo tanto, la infraestructura física sigue siendo un punto de riesgo, incluso en la nube pública.
¿Cómo vivió España la caída de Google Cloud?
Aunque el centro de datos estaba en Londres, en España el impacto se sintió sobre todo entre los clientes de Revolut. Según Revista Cloud, Revolut identificó problemas en 31 servicios en España. Entre ellos estaban los pagos con tarjeta, las transferencias, los retiros en cajeros, las recargas de saldo y las operaciones de inversión.
En la práctica, muchos clientes no pudieron abrir la app ni pagar en comercios durante la mañana. Las tarjetas aparecían como denegadas en tiendas físicas. Hacia las 13:15, hora española, Google dio por resuelto el problema eléctrico y los servicios se recuperaron de forma gradual.
La lección para la banca y las fintech españolas es clara: un banco puede operar en España y depender, sin que el cliente lo sepa, de infraestructura ubicada en otro país. Por eso, DORA, vigente desde enero de 2025, exige a las entidades financieras de la Unión Europea gestionar el riesgo de sus proveedores tecnológicos críticos y probar sus planes de continuidad.
¿Por qué una falla en una zona llegó a la app del banco?
Las nubes públicas se organizan en regiones, y cada región tiene varias zonas independientes. En teoría, la caída de una zona no debería tumbar un servicio bien diseñado. En la práctica, sí ocurre cuando una aplicación, o alguno de sus componentes, vive en una sola zona.
El problema suele estar en las dependencias que nadie mapeó. Por ejemplo, la app móvil puede estar replicada, pero el servicio de autenticación, la base de datos de sesiones o una cola de mensajes quizá no. Así, basta con que falle una pieza para que el cliente vea un error al iniciar sesión.
El riesgo de concentración ya es un tema regulatorio
La banca europea depende en gran medida de pocos proveedores de nube. Ese riesgo de concentración dejó de ser una preocupación teórica y ya tiene marco legal.
- Unión Europea: bajo DORA, el Reglamento de Resiliencia Operativa Digital, las autoridades supervisoras europeas publicaron en noviembre de 2025 la lista de proveedores TIC críticos. Incluye a Google Cloud, AWS, Microsoft y Oracle, entre 19 empresas.
- Reino Unido: el Tesoro británico designó en julio de 2026 a sus primeros terceros críticos para el sistema financiero, también proveedores cloud. Según el análisis del despacho HSF Kramer, los bancos mantienen intactas sus propias obligaciones de resiliencia.
- Perú: el Reglamento de Gestión de la Seguridad de la Información y la Ciberseguridad de la SBS (Resolución SBS N.° 504-2021) pide una estrategia de salida para los servicios significativos que presta un tercero, incluida la nube.
En otras palabras, que el proveedor esté supervisado no traslada la responsabilidad. La entidad financiera sigue respondiendo por la continuidad de sus servicios ante el regulador y ante sus clientes.
Lecciones de la caída de Google Cloud para tu arquitectura
La caída de Google Cloud deja tres lecciones prácticas. Sirven para la banca, pero también para minería, energía, retail o cualquier empresa con operación digital crítica.
1. Elige el arquetipo correcto: zonal, regional o multirregional
La propia guía de arquetipos de despliegue de Google Cloud distingue tres niveles. El despliegue zonal concentra todo en una zona y se recomienda para desarrollo, pruebas o cargas no críticas. El regional reparte réplicas entre varias zonas de una región y protege ante la falla de una zona. En cambio, el multirregional replica en dos o más regiones y es el indicado para cargas de misión crítica.
La decisión depende del costo, la complejidad y el impacto de una caída. Sin embargo, una banca móvil o un sistema de pagos difícilmente justifica un diseño zonal.
2. Mapea las dependencias ocultas
Haz un inventario de cada servicio crítico y de todo lo que necesita para funcionar: identidad, DNS, bases de datos, colas, certificados y servicios de terceros. Luego, verifica en qué zona o región vive cada pieza. Un tablero en Power BI con este mapa ayuda a que negocio y TI hablen el mismo idioma.
3. Prueba la conmutación, no solo la documentes
Un plan de recuperación que nunca se ensayó es una hipótesis. Programa pruebas controladas en las que apagues una zona y midas cuánto tarda el servicio en recuperarse. Con Cloud Load Balancing y Cloud DNS puedes redirigir tráfico entre zonas o regiones, y con réplicas de Cloud SQL puedes reducir la pérdida de datos.
Multinube o multirregión: cómo decidir
Tras cada gran incidente reaparece la idea de usar varios proveedores a la vez. La estrategia multinube con AWS, Azure, Google Cloud u Oracle Cloud reduce la dependencia de un solo actor. No obstante, MarketScreener recuerda que suma costos de integración, mantenimiento y seguridad, y que no garantiza una conmutación inmediata.
En la práctica, muchas organizaciones obtienen más resiliencia por peso invertido con un buen diseño multirregional dentro de un mismo proveedor. La multinube tiene sentido para servicios muy críticos o cuando el regulador exige una salida real y probada. Para decidir, usa estos criterios:
- Impacto del corte: cuánto pierde el negocio por cada hora sin servicio.
- Objetivos de recuperación: tiempo máximo de caída y pérdida de datos aceptables.
- Exigencias regulatorias: DORA, el régimen británico o la SBS, según dónde operes.
- Capacidad del equipo: operar dos nubes requiere habilidades y procesos para ambas.
- Portabilidad: cuánto depende tu aplicación de servicios propios de un proveedor.
Checklist de resiliencia cloud para los próximos 30 días
Si la caída de Google Cloud te dejó con dudas, empieza por estas acciones concretas:
- Lista tus diez servicios más críticos y su arquetipo actual: zonal, regional o multirregional.
- Mapea sus dependencias e identifica cualquier componente que viva en una sola zona.
- Define objetivos de recuperación por servicio junto con las áreas de negocio.
- Revisa tus contratos cloud: acuerdos de nivel de servicio, notificación de incidentes y estrategia de salida.
- Agenda una prueba controlada de caída de zona en un entorno no productivo.
- Prepara mensajes para clientes y canales de atención ante una interrupción.
- Presenta al comité de riesgos un plan priorizado con costos y plazos.
Conclusión: la caída de Google Cloud como punto de partida
La caída de Google Cloud en Londres no fue la primera ni será la última falla de un proveedor de nube. Sin embargo, sí deja claro que la resiliencia no se compra con el contrato: se diseña, se prueba y se gobierna. Además, con DORA, el régimen británico y la SBS, también se audita.
En Touch Consulting acompañamos a empresas de Perú y España a evaluar y rediseñar su arquitectura en Google Cloud, AWS, Azure y Oracle Cloud con nuestros servicios Cloud. También reforzamos la postura de riesgo con ciberseguridad y damos soporte continuo con servicios de TI gestionados.
¿Sabes qué pasaría con tus servicios críticos si mañana cae una zona de tu proveedor cloud? Conversemos y revisemos tu resiliencia.